


Chatbot versagt im Lotsendienst
Liebe KI, ich habe Schmerzen im Knie – viele Menschen vertrauen ihre Symptome Chatbots der Künstlichen Intelligenz an. Eine Studie zeigt, dass die Sprachmodelle fast immer zum Arztbesuch raten. In Verbindung mit Symptomchecker-Apps könnten sie aber die Gesundheitskompetenz erhöhen.
Sofort in die Notaufnahme, erstmal zum Hausarzt oder einfach abwarten? Bei der Steuerung von Patientinnen und Patienten soll nach aktuellen Reformplänen die Digitalisierung helfen. So sieht beispielsweise der Gesetzentwurf zur Reform der Notfallversorgung eine digitale Ersteinschätzung vor. Im Entwurf des Gesetzes für Daten und digitale Innovation im Gesundheitswesen ist ein digitaler Zugangsweg in die Versorgung über die elektronische Patientenakte vorgesehen. Mit Systemen zur digitalen Ersteinschätzung sollen Patientinnen und Patienten selbst ihre Sym-ptome bewerten können und so zur passenden Art der Versorgung gelotst werden.
Bereits heute nutzen viele Menschen unregulierte und nicht-qualitätsgesicherte Anwendungen Künstlicher Intelligenz (KI), um zu entscheiden, ob sie medizinische Versorgung benötigen und wo sie diese erhalten. In einer aktuellen Befragung des Branchenverbandes Bitkom berichteten 73 Prozent der Teilnehmenden, dass sie das Internet für Gesundheitsfragen nutzen. Dabei verschiebt sich die Nutzung von Suchmaschinen langsam hin zu KI-Chatbots. So gaben 45 Prozent der Befragten Ende 2025 an, diese Chatbots zur Symptomanalyse oder Beantwortung von Gesundheitsfragen zu nutzen.
Das ist versorgungspolitisch deshalb relevant, weil es nicht nur um Wissensvermittlung, sondern auch um konkrete Handlungsempfehlungen und damit verbundene Effekte auf das Gesundheitssystem geht. Einer aktuellen Studie zufolge holen Nutzer von Chatbots hauptsächlich Zweitmeinungen ein, entscheiden, ob und wo medizinische Hilfe aufgesucht werden muss, und klären offene Verständnisfragen (El-Osta et al., 2026).
Dabei sind sie sich der Risiken bewusst. Zwar haben sie großes Vertrauen zu Chatbots, wenn es darum geht, die eigene Gesundheitskompetenz zu fördern. Bei Hochrisikoentscheidungen wie der Beurteilung der Schwere von Symptomen oder der Einschätzung eines Notfalls, ist das Vertrauen aber eher gering. Zur Unterstützung bei der Frage, ob professionelle medizinische Abklärung notwendig sein könnte, ist das Vertrauen wiederum hoch.
Vergleich mit Expertenrat
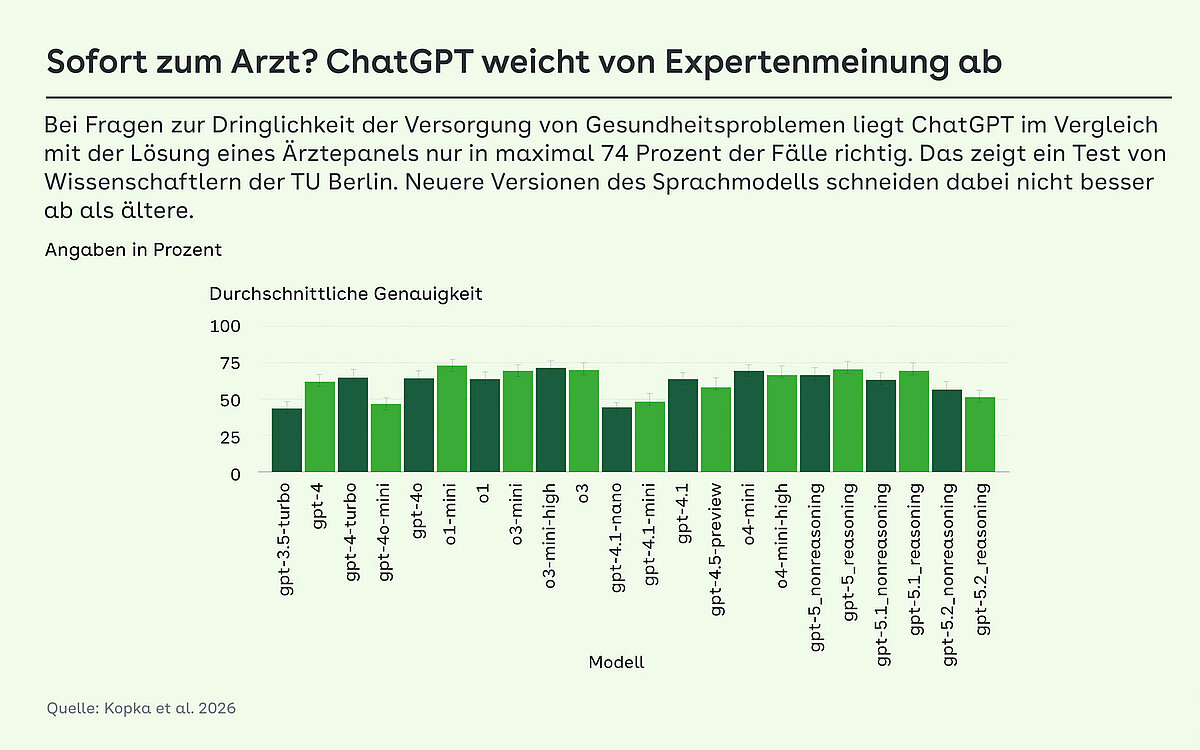
Ob der aktuell am meisten genutzte Chatbot ChatGPT zur Patientensteuerung sinnvoll sein kann, hat ein Team am Institut für Psychologie und Arbeitswissenschaft der Technischen Universität Berlin in einer Studie (Kopka et al., 2026) getestet: Dafür wurden 45 Fälle, zu denen Patienten online um Rat zur Versorgungsdringlichkeit gefragt haben, mit allen bis zum Untersuchungszeitpunkt veröffentlichten OpenAI-GPT-Modellen getestet – von der ersten GPT 3.5 bis zur aktuelleren GPT 5.2 Version. Im Vorhinein hat ein Ärztepanel zu jedem Fall die angemessene Versorgungsstufe (das heißt Notaufnahme, Arztbesuch, Selbstversorgung) festgelegt, um die Antworten der Modelle mit dieser Ideallösung abzugleichen. Die Genauigkeit wurde dabei als Hauptkennwert betrachtet und als Mittelwert der richtig gelösten Fälle über alle Fälle hinweg definiert. Dieser Kennwert ist das Maß dafür, zu welchem Prozentsatz die Empfehlungen in der Realität korrekt sein werden. Dies ist möglich, da die Zahl der jeweiligen Fälle an der Häufigkeit ausgerichtet war: Da wirkliche Notfälle selten sind und noch seltener vor dem Notruf erst in Chatbots eingegeben werden, beinhalteten auch die getesteten Fälle nur wenige Notfallszenarien. Relevanter war also die Frage, ob ein Arztbesuch überhaupt notwendig ist.
Neben der Genauigkeit hat das Forscherteam auch die Variabilität der Antworten bestimmt. Large Language Models (LLMs) geben durch ihre Systemarchitektur unterschiedliche Ausgaben auf die exakt gleichen Eingaben. Deshalb haben die Wissenschaftler – zur Bestimmung dieser Variabilität – jeden Fall zehnmal eingegeben. Dadurch ließ sich außerdem quantifizieren, wie häufig Nutzer jedes Modells im Alltag mit unterschiedlichen Empfehlungen für gleiche Fälle zu rechnen haben. Um bei dieser Evaluation keine verfälschenden Faktoren einzubringen, erfolgten die Abfragen automatisiert mit den gleichen Einstellungen und Eingaben für alle Modelle.
Abwarten ist keine Option
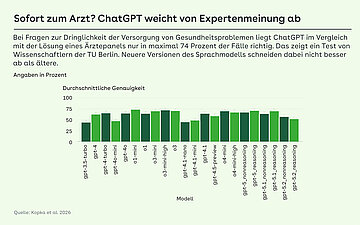
Bei 22 getesteten Modellen ergab sich somit eine Gesamtzahl von 9.900 Einzelabfragen. Das beste Modell erreichte eine Genauigkeit von 74 Prozent. Dieser Wert verbesserte sich mit neueren Modellen nicht generell. Das ist bemerkenswert, weil neuere Modelle in anderen Bereichen meist als leistungsfähiger gelten. Für die Patientensteuerung zeigt sich dieser Fortschritt offenbar nicht. Ein Blick auf die Fälle liefert eine Erklärung: Die Modelle waren grundsätzlich fast alle gut darin, Nutzern zu einem Arztbesuch zu raten (auch wenn gelegentlich stattdessen die Notaufnahme vorgeschlagen wurde). Nur selten beinhalteten die Antworten der Chatbots die Empfehlung, zu Hause zu bleiben und Symptome selbst zu versorgen oder erst einmal abzuwarten. Einem 25-jährigen Patienten, dem der Arm nach einer Übung beim Bizepstraining bei gleicher Bewegung leicht schmerzte, rieten die Chatbots, direkt zum Arzt zu gehen, teilweise rieten sie sogar zum Besuch der Notaufnahme. Diese Tendenz, eine dringlichere Versorgungsstufe als notwendig zu empfehlen, zeigte sich über alle Modelle hinweg – besonders aber bei den ältesten und den neuesten.
Auch bei der Variabilität zeigten sich große Unterschiede: Bei etwas mehr als zwei Dritteln aller Fälle war die Empfehlung entweder immer richtig oder immer falsch. Bei den restlichen Fällen war die Empfehlung (trotz exakt gleicher Eingabe und gleichem Modell) mal richtig und mal falsch. Die größte Variabilität eines Einzelmodells lag bei über 42 Prozent. Besonders auffällig war dieses Muster wieder bei Fällen, die für die Selbstversorgung geeignet gewesen wären. In lediglich vier von 13 Selbstversorgungsfällen waren die Antworten zumindest bei zwei Modellen konsistent richtig. Alle anderen Modelle und auch alle anderen Fälle wurden trotz gleicher Eingabe in den verschiedenen Durchgängen unterschiedlich bewertet.
ChatGPT würde Wartezimmer füllen
Diese Ergebnisse lassen darauf schließen, dass ChatGPT in der aktuellen Form zur Patientensteuerung kaum bis gar nicht geeignet ist. Obwohl die Empfehlungen zumindest nur selten zu Schäden für Nutzer geführt hätten, würde ein Befolgen der Ratschläge zu unverhältnismäßiger Beanspruchung von Arztpraxen und Notaufnahmen führen. Da die meisten Modelle nahezu niemals Selbstversorgung empfohlen haben, könnte der einfache Vorsatz der Patienten, mit jedem Symptom gleich zum Arzt zu gehen, zum selben Ergebnis führen. Dann jedoch ist der Einsatz eines Chatbots überflüssig.
Die Unterhaltung mit KI kann für Nutzer dennoch hilfreich sein, denn neben einer reinen Empfehlung geben ChatGPT und andere LLMs diverse andere Informationen aus. Dabei haben sie zwei Vorteile, die weder Google noch eine Telefonhotline bieten können: hyperpersonalisierte Informationen und unbegrenzte Rückfragen. Wer LLMs für Gesundheitsinformationen konsultiert, möchte in der Regel mehr lernen. Studien zeigen, dass Patienten Empfehlungen und Informationen kritisch hinterfragen, wenn sie nicht zu ihrer Situation oder ihrem Vorwissen passen. Oft prüfen sie das auch anhand anderer Quellen. Während Fachleute mit Blick auf die Informationsqualität vor jeglicher Nutzung der Systeme warnen, findet daher ein großer Teil der Bevölkerung diese Tools hilfreich.
Wie hilfreich Chatbots im Einzelfall sind, hängt aber stark von den jeweiligen Fertigkeiten und Erfahrungen der Nutzer ab. Wenn sie eine simple Frage mit wenig Informationen stellen („Mein Knie tut weh, was soll ich tun?“), ist die Antwort vermutlich weniger hochwertig als bei komplexeren Eingaben mit Kontextinformationen. Nutzer könnten zum Beispiel das LLM instruieren, die Rolle eines Orthopäden einzunehmen, nach Kontextinformationen wie Auslösern oder Dauer zu fragen, sowie entsprechende Leitlinien und wissenschaftlich anerkannte Artikel zu durchsuchen, um daraus eine Evidenzsynthese herzustellen und diese mit den eingegebenen Symptomen zu verknüpfen, um mögliche weitere Schritte abzuleiten. So könnten LLMs geeignet sein, niederschwellig und rund um die Uhr Informationen auszugeben und aus vielen Informationen „Sinn zu machen“, also Wissenslücken zu füllen und Verständnis herzustellen. So ließen sich LLMs dafür nutzen, die richtige Fachrichtung für Symptome zu erfragen oder informierter in ein Arztgespräch zu gehen.
Sprache suggeriert Professionalität

Ein Problem dabei haben allerdings besonders neuere Modelle: Eine professionelle Kommunikation wirkt zwar seriös, und das Nennen von Warnzeichen macht die Empfehlung auch ziemlich sicher für Patienten. Wenn der Chatbot allerdings bei den harmlosesten Beschwerden, wie etwa Knieschmerzen nach Überlastung, empfiehlt, erstmal zu Hause zu bleiben, aber bei einem von zehn zusätzlichen Warnsignalen (Fieber, Taubheit und vieles mehr) rät, sofort in die Notaufnahme zu gehen, wirken harmlose Beschwerden deutlich dringender, als sie tatsächlich sind. Ebenso klingen professionelle medizinische Bezeichnungen wie „Tractus-iliotibialis-Friktionssyndrom am lateralen Femurepikondylus“ – wie ChatGPT sie gerne ausgibt – deutlich schlimmer und dringlicher als eine „Reizung der Beinsehne durch Überlastung“. Diese Professionalität wird zum Problem, da die Warnsignale und Fachbegriffe für viele Nutzer ernst wirken. Sie zeigen ihnen indirekt, dass hier das Ende einer Chatbot-Nutzung erreicht zu sein scheint und professionelle Abklärung notwendig wäre – auch wenn dies nicht zutrifft. Über diesen Mechanismus und neu auftretende Beunruhigung tragen ChatGPT und andere LLMs sogar mit nicht-dringlichen Empfehlungen dazu bei, dass Nutzer häufiger zum Arzt gehen als eigentlich nötig. Für eine sinnvolle Anwendung wäre wichtig, die Informationen nicht mit übermäßiger Vorsicht und höchst professioneller Ausdrucksweise ausgeben zu lassen, sondern in einer Sprache, die für die Nutzerinnen und Nutzer passend und verständlich ist.
Chatbots als Ergänzung
Für Empfehlungen, was bei Sym-p-tomen zu tun ist, sind zertifizierte Anwendungen besser geeignet. Sie erfüllen die Anforderungen der Medizinprodukteverordnung und müssen ihre Genauigkeit und Sicherheit nachweisen. Chatbots und LLMs könnten dennoch eine wertvolle Ergänzung liefern, indem sie Informationen verständlich aufbereiten. Probleme mit einer fachlichen Ausdrucksweise gibt es auch in zertifizierten Anwendungen. Mit einem qualitätsgeprüften Algorithmus, der auf dieselbe Eingabe immer dieselbe Empfehlung gibt und dabei transparent und nachvollziehbar ist, können Empfehlungen abgesichert werden. Ein KI-Chatbot könnte anschließend auf Basis der Empfehlung offene Fragen beantworten, schwierige Begriffe erklären und Lücken im Verständnis füllen.
Mitwirkende des Beitrags
Autorin
Datenschutzhinweis
Ihr Beitrag wird vor der Veröffentlichung von der Redaktion auf anstößige Inhalte überprüft. Wir verarbeiten und nutzen Ihren Namen und Ihren Kommentar ausschließlich für die Anzeige Ihres Beitrags. Ihre E-Mail-Adresse wird nicht veröffentlicht, sondern lediglich für eventuelle Rückfragen an Sie im Rahmen der Freischaltung Ihres Kommentars verwendet. Die E-Mail-Adresse wird nach 60 Tagen gelöscht und maximal vier Wochen später aus dem Backup entfernt.
Allgemeine Informationen zur Datenverarbeitung und zu Ihren Betroffenenrechten und Beschwerdemöglichkeiten finden Sie unter https://www.aok.de/pp/datenschutzrechte. Bei Fragen wenden Sie sich an den AOK-Bundesverband, Rosenthaler Str. 31, 10178 Berlin oder an unseren Datenschutzbeauftragten über das Kontaktformular.